摘要:本篇是"银行业经营收益引擎"系列第 9 篇,讲监管报送自动化与口径治理——这是 CIO 和 CDO 级的痛点:报送出了问题,背锅的是数据治理和科技负责人,不是业务。EAST、1104、客户风险这些报送,口径复杂(同一指标不同报表口径还不一样)、跨部门(数据来自信贷、运营、财会多个系统)、容易错,一个口径错了全行返工,报送季加班是常态,监管检查和审计来了提心吊胆。极昆仑iInsight 做三件事:①口径差异自动归因——两张表同一指标差了几千万,自动定位到根因(口径定义、系统时点、数据源),不用人工对着报表猜;②全链路可追溯——每个差异数字都能展开看原始记录、SQL、计算时间,监管检查/审计问起来当场核;③整改工单 + 口径治理建议 + 审计证据包,把"发现问题"变成"整改闭环"。收益按报送专职 40 人、差异返工减少算,一年节约约 900 万(只是举例不是承诺)。**红线:不自主提交监管报送、不自主修改监管口径。**兑现确定性标"高"——口径归因当天可验。
先破一个误区:很多人以为监管报送就是"填表",照着格式填就行。真相是,EAST、1104、客户风险这些报送,口径复杂到让人崩溃:同一个"贷款余额",EAST 表里是一种口径、1104 里是另一种口径、客户风险报表又是第三种;数据来自信贷、运营、财会好几个系统,每个系统结账时点还不一样——差一分钱都要查到底,差一个口径全行返工。
还原一次报送季的真实过程:
报送专员对账:EAST 表里"贷款余额"是 680 亿,1104 表里是 675 亿,差 5 个亿;
开始排查:是口径定义不同(一个含贴现、一个不含)?还是系统时点不同(一个结到月末、一个结到月最后一天)?还是某个数据源漏了?
对着两张报表猜了一天,问了好几个部门,最后发现是口径问题——返工重报,全行报送组加班到凌晨;
这还不是最惨的——最惨的是监管检查/审计来查,问你"这个数为什么是这个值",你拿不出"怎么算出来的"的完整链条,只能赔笑说"我们回头核实"。
这不是段子,是报送季的常态。三个问题:
1. 口径复杂,人工对不齐。 同一指标跨报表口径不同、跨系统时点不同,人工对着报表一张张对,对不出来是常态,差一分钱都得返工。
2. 错了全行返工。 一个口径错,全量重报,报送季加班是固定的——返工成本比正常报送还高。
3. 审计压力大。 监管检查和内部审计要你解释每个数字,人工给不出"这个数怎么来的"的可追溯链条——问起来答不上来,就是审计整改项,重则监管处罚。
一个常被忽略的真相:报送的价值不在"把表填出来",在"每个数字都经得起问"。 监管检查和审计要的不是"数字对",是"你说清楚这个数字怎么来的"。能对口径差异自动归因、每个数字能展开到原始记录和 SQL,报送从"提心吊胆"变成"有底气"——这才是报送治理该干的事。
环节 | 传统方式 | 极昆仑iInsight | 差异 |
口径差异发现 | 人工对报表,对不出来靠猜 | 自动发现两张表同一指标的差异 | 从"人工对表"到"自动发现" |
差异归因 | 对着报表猜一天,问好几个部门 | 自动归因到根因:口径定义、系统时点、数据源 | 从"猜"到"定位根因" |
可追溯性 | 答不上来"这个数怎么来的" | 每个差异数字可展开看原始记录、SQL、计算时间,全链路可追溯 | 从"提心吊胆"到"可当场核" |
整改闭环 | 返工完就完了,根因没治理 | 自动生成整改工单 + 口径治理建议,防止再犯 | 从"返工了事"到"根因治理" |
审计应对 | 审计问起来答不上来 | 审计证据包自动生成,被查有底气 | 从"赔笑核实"到"拿证据说话" |
合规红线 | —— | 不自主提交监管报送、不自主修改监管口径 | 从"没有边界"到"红线内运行" |
关键差异:传统方式是"报送专员对着报表猜、返工、被审计问得答不上来";极昆仑iInsight 是"差异自动发现、归因到根因、每个数字可追溯到原始记录和 SQL、整改工单闭环、审计证据包自动生成"。
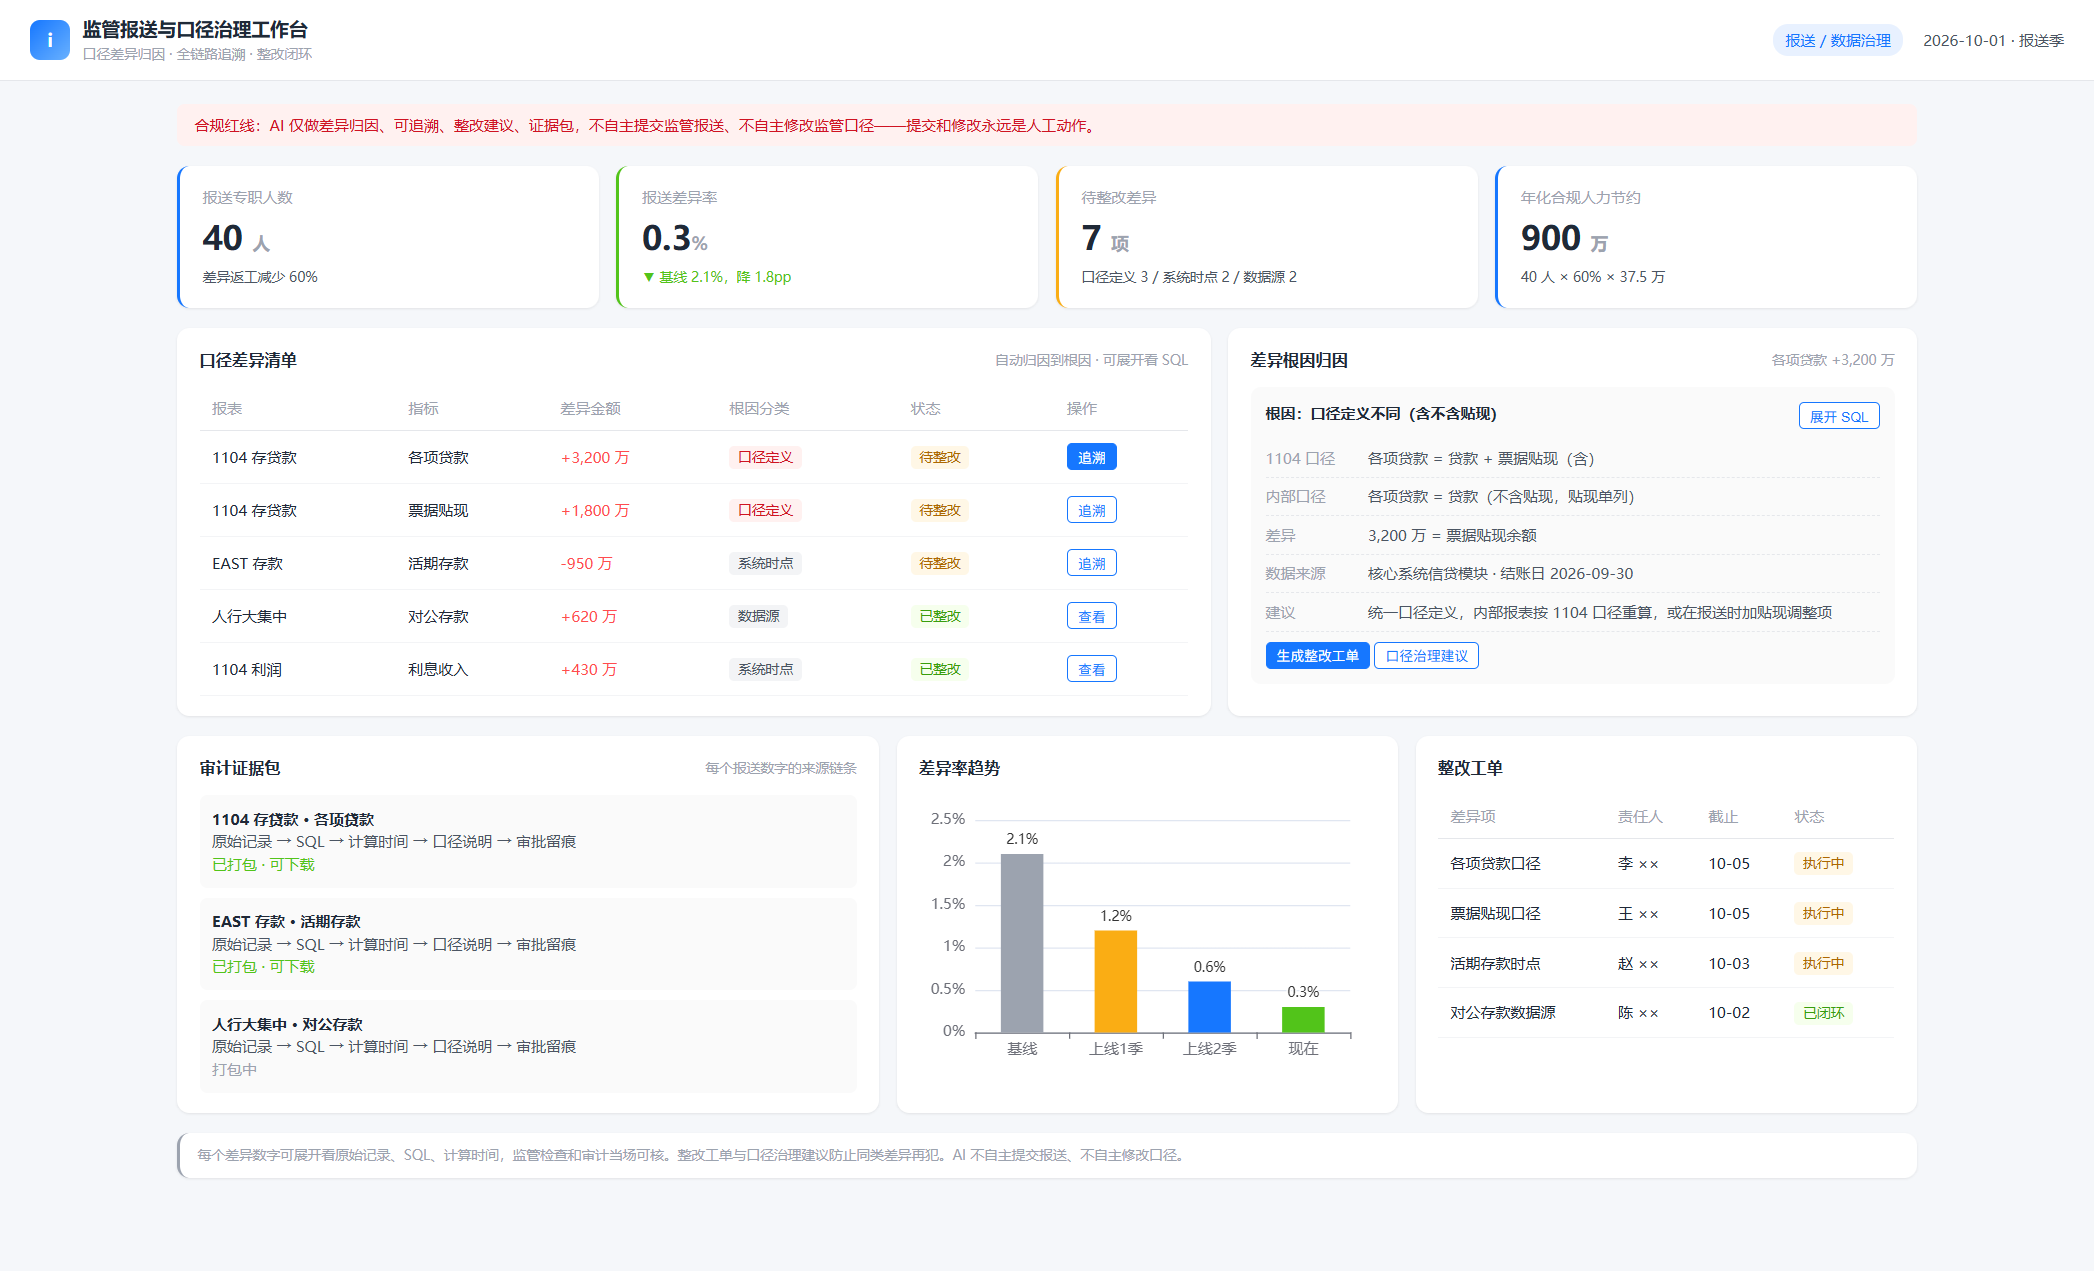
红线不变:AI 只做归因和证据,不自主提交监管报送、不自主修改监管口径。
自家试算:你拿自家报送团队就能算
以下所有数字为示例口径,只是举例不是承诺。请用自家数据套公式自算。
① 基础参数(3 个数)
参数 | 含义 | 示例取值 | 数据来源 |
P | 报送专职人数 | 40 人 | 行内报送团队配置 |
ρ | 差异返工减少比例 | 60% | 推演值:差异自动归因 + 整改闭环后的返工下降 |
C | 人均年全成本 | 37.5 万 | 行内人力成本口径(报送/数据治理岗位) |
② 极昆仑iInsight 带来的动作变化
口径差异自动归因:两张报表同一指标差了几千万,自动定位根因——口径定义不同(含不含贴现)、系统时点不同(结账日差异)、数据源缺失,不用人工对着报表猜;
全链路可追溯:每个差异数字都能展开看原始记录、SQL、计算时间,监管检查和审计问起来当场核;
整改工单 + 口径治理建议:差异定位后自动生成整改工单(谁改、怎么改、什么时候)和口径治理建议(从根上统一口径),防止再犯;
审计证据包:被审计/监管检查前,自动生成审计证据包——每个报送数字的来源链条打包好,被查有底气;
红线内运行:AI 全程只做差异归因、可追溯、整改建议、证据包,不自主提交监管报送、不自主修改监管口径——提交和修改永远是人工动作。
动作变化量化:口径差异从"人工对表猜一天"到"自动归因到根因";报送差异率从 2.1% 压到 0.3%(示例口径);每个数字从"答不上来"到"可展开核 SQL";报送季从"返工加班"到"整改闭环"。
③ 经营结果(公式 + 举个例 + 因果链)
公式:
年化合规人力节约 ≈ P × ρ × C
其中:
P = 报送专职人数
ρ = 差异返工减少比例
C = 人均年全成本
举个例(5000 亿资产城商行口径):
P = 40 人,ρ = 60%,C = 37.5 万
40 × 60% × 37.5 万 = 900 万
这个 900 万是合规人力节约口径(示例口径):差异返工减少 60% 后,40 人报送团队释放的工时折算。它是"少加了多少班、少返了多少工",不是"省下来的钱自动进利润"——释放的人力转做口径治理、数据分析,还是维持原配置提高报送质量,取决于行里安排。
你家用自家数代:P 是 20 人还是 80 人,ρ 是 40% 还是 80%,C 是 25 万还是 50 万,自己算。P=20、ρ=40%、C=25 万算出来约 200 万;P=80、ρ=80%、C=50 万算出来约 3200 万——值不值立项,你比我清楚。
诚实边界(务必看):①这个场景真正的价值不只是省人力——还有"审计通过率提升、监管处罚风险下降、口径治理从根上解决",这些不好量化,但价值往往比 900 万更大,汇报时别只讲人力节约;②差异返工减少比例 60% 是推演值,取决于你家的报送差异量级和口径治理基础;③红线必须说清楚:AI 不自主提交监管报送、不自主修改监管口径——报送的提交和口径的修改,永远是人工动作,这是监管场景敢用 AI 的前提。
因果链(为什么这个数能成立):
经营场景:监管报送自动化与口径治理
↓ 第一层(技术能力)
· 智能问数 + 确定性编译(口径差异计算 100% 正确可追溯)
· 差异归因(口径定义、系统时点、数据源三类根因自动定位)
· 全链路追溯(每个数字展开看原始记录、SQL、计算时间)
· 工作流对接(整改工单 + 口径治理建议 + 审计证据包)
· 合规红线(AI 不自主提交监管报送、不自主修改监管口径)
↓ 第二层(经营动作变化)
① 差异发现从"人工对报表对不出来"→"自动发现两张表同一指标的差异"
② 差异归因从"对着报表猜一天"→"自动定位根因:口径定义/系统时点/数据源"
③ 可追溯性从"答不上来这个数怎么来的"→"每个数字可展开核 SQL,全链路可追溯"
④ 整改从"返工完就完了"→"整改工单 + 口径治理建议,防止再犯"
⑤ 审计应对从"审计问起来答不上来"→"审计证据包自动生成"
↓ 第三层(经营结果,自家数据自算)
年化合规人力节约 ≈ P × ρ × C
效果参考口径(示例值,非客户实际数据):
报送专职 40 人,EAST/1104/客户风险报送差异人工对表;
口径差异自动归因 + 全链路可追溯 + 整改工单闭环,报送差异率从 2.1% 压到 0.3%、差异返工减少约 60%(示例口径);
一年节约约 900 万(示例口径)。
以上 40 人、2.1%、0.3%、60%、900 万均为示例值,不是承诺。你家的实际数取决于报送差异量级、口径复杂度、报送团队配置。口径归因当天可验;更大的价值在审计通过率和监管风险下降,不好量化但价值更大。
这是本场景最关键的差异化。通用 ChatBI 和智能问数产品在监管报送场景里能做的,和 极昆仑iInsight 做的,差"归因 + 追溯 + 确定性"三层。
能力维度 | 通用 ChatBI / 智能问数 | 极昆仑iInsight |
查报送指标数值 | ✅ 能做 | ✅ 能做 |
拉两张报表对账 | ✅ 勉强能做 | ✅ 能做 |
出差异统计 | ✅ 能做 | ✅ 能做 |
差异自动归因(定位到口径定义/系统时点/数据源根因) | ❌ 只查出"有差异",说不出"为什么差" | ✅ 自动归因到根因 |
全链路可追溯(每个数字展开看原始记录、SQL、计算时间) | ❌ 给不出 | ✅ 每个数字可展开核 |
整改工单 + 口径治理建议 | ❌ 出不了工单 | ✅ 差异 → 整改 → 治理闭环 |
审计证据包(被查当场拿证据) | ❌ 给不出 | ✅ 自动生成审计证据包 |
确定性(监管场景最要"数字为什么是这个值") | ❌ 大模型回答不可控 | ✅ 确定性编译,100% 可追溯 |
合规红线(不自主提交/修改) | ❌ 没有这层设计 | ✅ 红线内置,提交和修改必须人工 |
壁垒拆解:
壁垒 1:差异归因,ChatBI 只查出"有差异" 两张报表差 5 个亿,ChatBI 能帮你查出来"有差异",但说不出"为什么差"——是口径定义不同、系统时点不同、还是数据源缺失?监管报送场景里,"查出差异"只是开始,"归因到根因"才是价值。人工对着报表猜一天的事,ChatBI 帮不了,因为归因要理解口径定义、跨系统时点,不是查表能解决的。
壁垒 2:全链路可追溯,监管要的是"数字为什么是这个值" 监管检查/审计问"这个数怎么来的",要的是从原始记录、SQL、计算时间到最终数字的完整链条。通用 ChatBI 给不出可追溯的链条(大模型生成的内容天然不可控、不可追溯)——在监管场景,不可追溯等于不可信,等于不能用。极昆仑iInsight 的确定性编译保证每个数字 100% 可追溯,这是监管场景敢用的前提。
壁垒 3:要的是"整改闭环",不是"对完账" 差异定位后要生成整改工单(谁改、怎么改、什么时候)、口径治理建议(从根上统一口径)、审计证据包(被查拿证据)——这是完整的治理闭环。ChatBI 对完账就结束了,差异还是那个差异,下次报送还是返工。
一句话:通用 ChatBI 解决"查得到数字、对得出账",极昆仑iInsight 解决"差异归因到根因、全链路可追溯、整改工单闭环、审计证据包、确定性编译"——而监管报送要的是每个数字经得起问 + 根因治理 + 红线内运行,不是一张对账表。这也是为什么说这是 CIO 和 CDO 级的痛点:可追溯和确定性,在合规那里最有说服力。
这个场景的口径归因当天就能验——兑现确定性"高",不依赖外部变量,不需要等效果期。
如果你家的报送团队也陷在"口径对不齐、一个错了全行返工、审计问起来答不上来"里,可预约一次 30 分钟需求对齐(不带销售,只看场景适配度——你家报送差异的量级、EAST/1104 的数据链路通没通、报送团队配置)。
需要的话可以进一步做 概念验证:拿你家历史报送差异案例(两张报表对不上的),跑"差异自动归因 + 全链路追溯",对比三件事:①归因准不准——AI 定位的根因(口径定义/系统时点/数据源),跟实际原因对不对得上;②可追溯性——每个差异数字能不能展开到原始记录和 SQL;③整改建议——生成的整改工单和治理建议,报送团队认不认。
验证什么、不验证什么,先说清楚:
概念验证验证的是差异归因准确性、全链路可追溯性、整改建议可用性——这些用历史报送差异数据当天能核;
概念验证不承诺"返工减少 60%"——那是推演值,取决于报送差异量级和口径治理基础;真正要跟领导讲的,除了省人力,还有审计通过率和监管风险下降,这个 POC 里能看到方向,但量化要时间;
红线当场演示:AI 只做差异归因、可追溯、整改建议、审计证据包,不自主提交监管报送、不自主修改监管口径——提交和修改永远是人工动作。
想试?拿你家历史上两张报表对不上的案例,我们跑"差异自动归因 + 全链路追溯"给你看:差 5 个亿能不能归因到根因、每个数字能不能展开核 SQL、整改建议认不认。红线也当场演示——提交报送、修改口径,AI 一概不碰。